Snowflake et Databricks sont les deux références des plateformes data sur le cloud. La question revient dans presque chaque projet : laquelle choisir ? Pour trancher autrement qu’avec des arguments marketing, notre équipe a monté un benchmark maison sur GCP : un pipeline dbt de 27 modèles et les 22 requêtes TPC-H, mesurés de SF1 à SF100 aux tarifs de mai 2026.
1. Notre protocole de test
Un benchmark data warehouse est facile à fausser sans le vouloir : comparer un cache actif d’un côté et coupé de l’autre, additionner les temps dbt par modèle plutôt que chronométrer le run complet, opposer un « Medium » Snowflake à un « Medium » Databricks comme s’ils coûtaient la même chose. On a donc figé un protocole et on ne publie que les chiffres dont on est certain.
- Données : TPC-H, un jeu de données de benchmark classique qui simule l’activité commerciale d’une entreprise (commandes, clients, fournisseurs). Il est fourni nativement dans Snowflake, ce qui permet de tester les performances sur des données cohérentes et faciles d’accès. On l’utilise à trois facteurs d’échelle : SF1 (~1 Go), SF10 (~9 Go) et SF100 (~90 Go).
- Charge : les 22 requêtes TPC-H (q01→q22), portées par un pipeline dbt de 27 modèles.
- Environnement : GCP eu-west1, compute serverless, avril–mai 2026.
- Mesure : le temps écoulé (
wall_seconds) au chronomètre externe, du début à la fin du run, et non la somme des temps du manifest dbt. - Robustesse : médiane sur 4 runs à cache chaud, cache ON/OFF séparés, warm-up pour neutraliser le cold-start.
- Tarifs : tarif facturé extrait des vues d’usage (mai 2026), pas le tarif catalogue des pages pricing.
Apparier ce qui coûte le même prix
Un « Large » Snowflake et un « Large » Databricks n’ont ni la même puissance ni le même tarif horaire. Pour comparer honnêtement, on aligne les configurations au même budget horaire : Snowflake Large (8 crédits/h, ~$20,80/h) et Databricks Medium (24 DBU/h, ~$21,84/h) tournent tous deux autour de $21/h. C’est le couple de référence du benchmark.
| Taille | SF (crédits/h) | DB (DBU/h) | Couplage budget | ≈ $/h |
|---|---|---|---|---|
| X-Small | 1 | 6 | — | — |
| Small | 2 | 12 | — | — |
| Medium | 4 | 24 | ↔ SF Large | ~$21,84 |
| Large | 8 | 48 | SF Large ↔ DB Medium | ~$20,80 |
| X-Large | 16 | — | — | — |
Six pièges classiques peuvent fausser ce type de benchmark. Les voici, du plus grave au moins grave, avec la parade appliquée à chacun :
| # | Le piège | Comment on l’évite |
|---|---|---|
| 1 | Cache ON / OFF | Deux séries de mesures distinctes, comparées chacune à son équivalent. |
| 2 | Durée cumulée | Chronomètre externe entre début et fin du dbt run, jamais la somme des temps par modèle. |
| 3 | Taille nominale | Apparier les configs au même budget horaire (SF Large ≈ DB Medium ≈ $21/h). |
| 4 | Tarif catalogue | Extraire le tarif facturé depuis les vues d’usage, pas la page pricing. |
| 5 | Échantillon N=1 | 3 runs minimum, médiane retenue, écart min/max reporté comme borne de variance. |
| 6 | Cold-start asymétrique | Requête de warm-up avant chaque mesure pour partir des deux plateformes déjà chaudes. |
2. Performance et coût à SF100
À SF100, une fois les configurations appariées au même budget, les deux plateformes se tiennent : Snowflake Large boucle le pipeline en 432 s pour $2,50, Databricks Medium en 428 s pour $2,60, soit un écart de coût de x1,04, dans la marge de bruit. Mais la moyenne masque l’essentiel. Quand on trace le coût par run en fonction de la durée, une frontière optimale se dessine, entièrement Databricks.
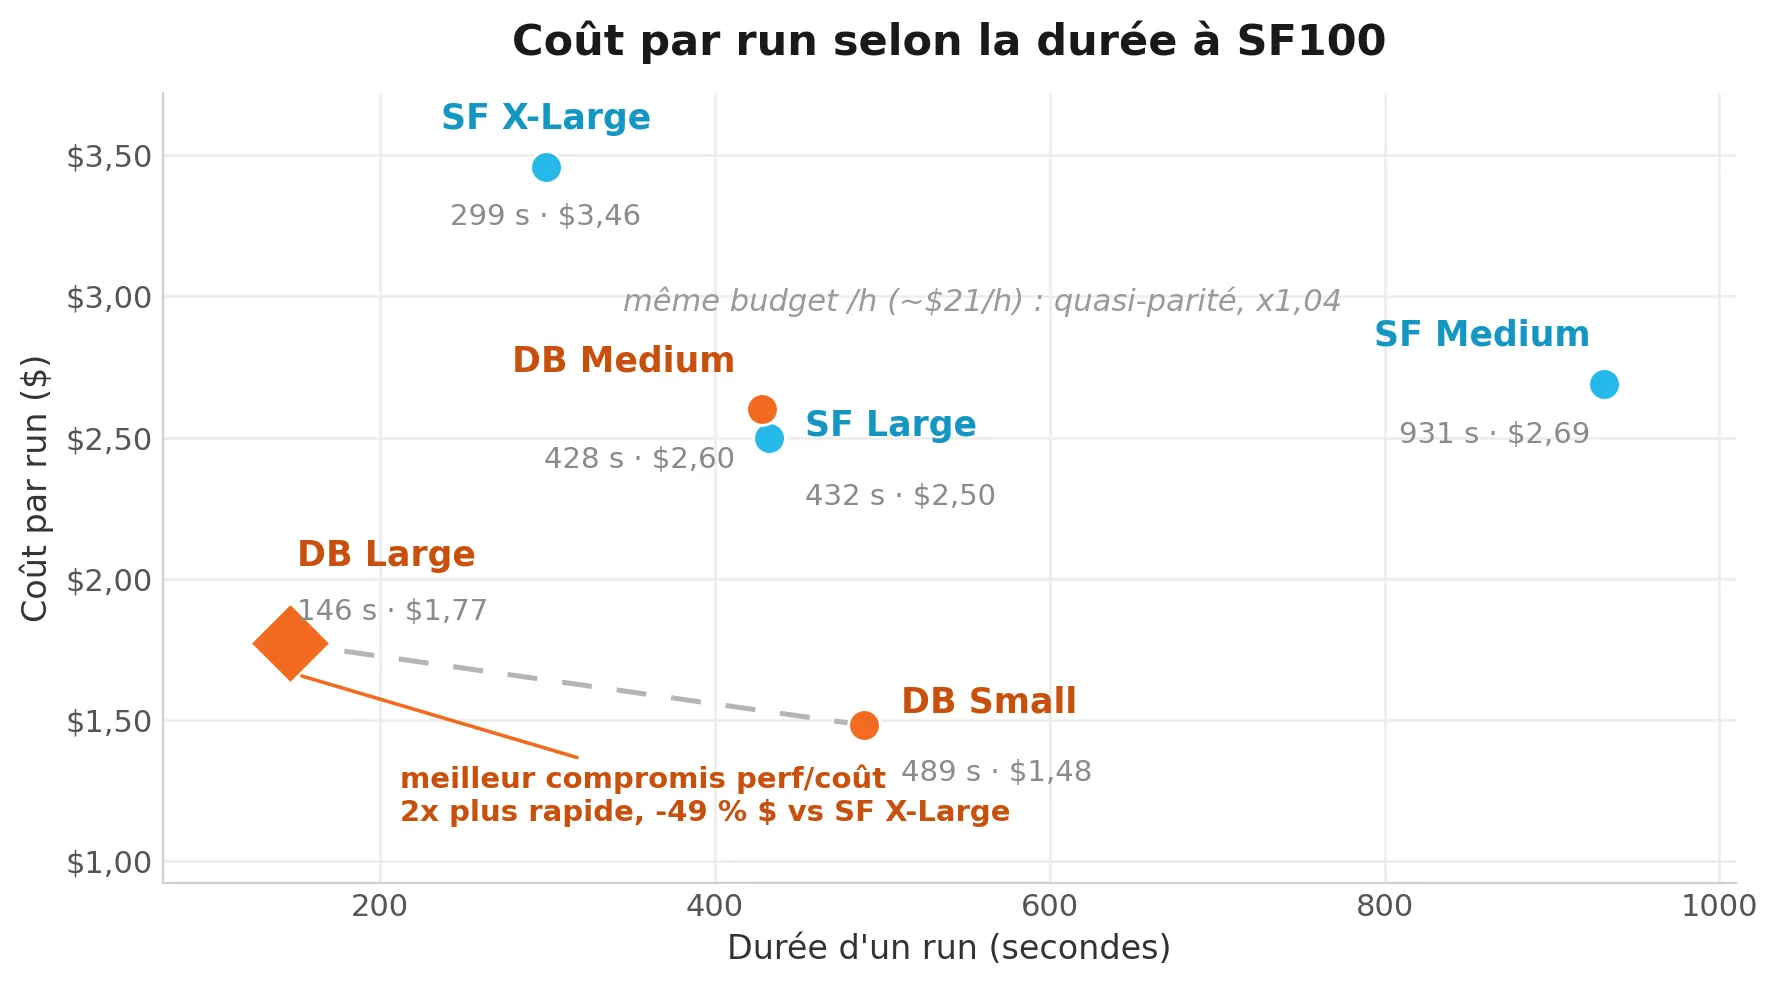
Le point remarquable, c’est Databricks Large : 146 s pour $1,77 par run. C’est le sweet spot de performance : 2x plus rapide que Snowflake X-Large (299 s) pour 49 % de coût en moins. Pour un SLA qui exige des batchs les plus courts possibles, c’est la configuration à retenir.
L’effet du volume de données
Le classement s’inverse avec le volume. C’est ce qui explique pourquoi tant de comparaisons se contredisent : elles ne testent pas à la même échelle.
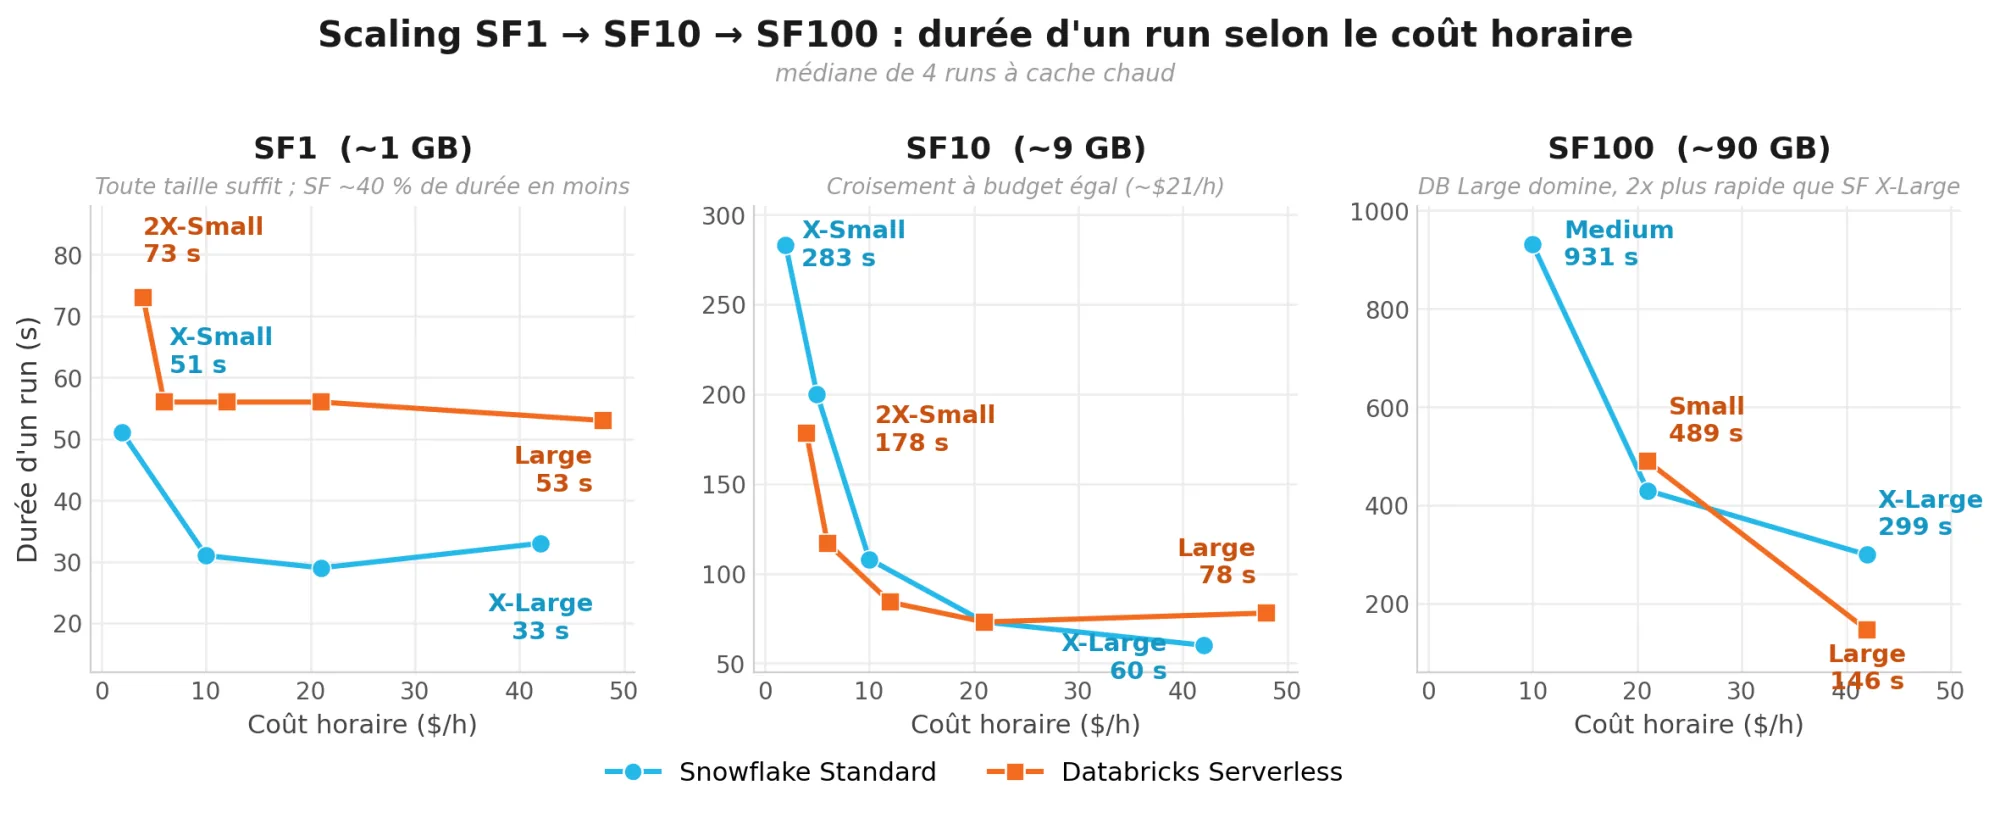
- Petits volumes (SF1, ~1 Go) : toute taille suffit ; Snowflake tient ~40 % de durée en moins, sans cold-start, plus prédictible.
- Volumes moyens (SF10, ~9 Go) : les deux plateformes se croisent au point de budget équivalent (~$21/h, ~73 s).
- Gros volumes (SF100, ~90 Go) : Databricks Large écrase la durée (146 s) là où Snowflake X-Large plafonne (299 s). L’avantage s’amplifie avec le volume.
3. Comportement sous charge parallèle
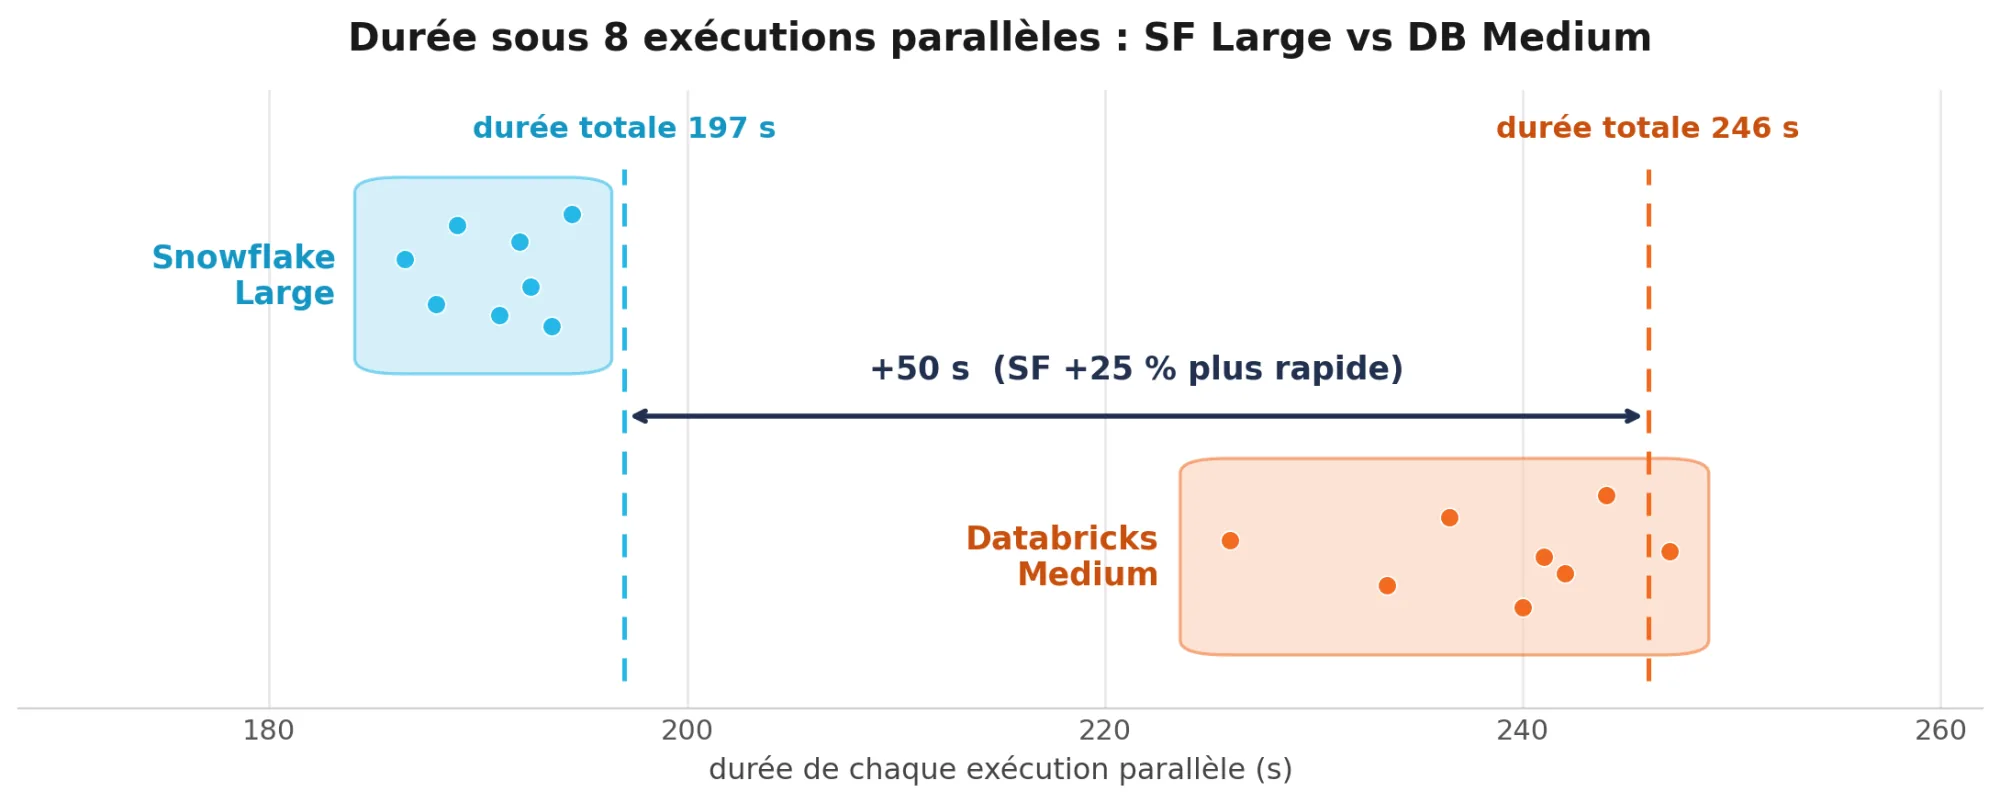
La performance d’un run isolé ne dit rien de la tenue sous concurrence. On a lancé le pipeline 8 fois en parallèle, à budget équivalent (SF Large vs DB Medium). Le classement de performance s’inverse à nouveau.
| Configuration | Durée totale | Écart min/max | $ / run |
|---|---|---|---|
| Snowflake Large | 197 s | 9 s | $1,14 |
| Databricks Medium | 246 s | 21 s | $1,50 |
Snowflake finit 50 s plus tôt (+25 %), pour 24 % moins cher, avec une variance deux fois plus basse entre exécutions. Sous forte concurrence (≥ 8 exécutions simultanées), il est donc à la fois plus rapide, moins cher et surtout plus stable. C’est un critère décisif quand plusieurs équipes utilisent la plateforme en même temps.
4. Le cache
Sur les 22 requêtes relancées à cache chaud, les deux moteurs récupèrent l’essentiel du temps : 91,4 % de gain moyen côté Snowflake Large, 87,8 % côté Databricks Medium. Les cas les moins favorables restent contenus (72,4 % pour Snowflake, 63,8 % pour Databricks). Sur des dashboards récurrents à scan large et agrégations stables (le cas d’usage type du cache), les deux convergent vers d’excellents gains. Bref, le cache ne départage pas les deux plateformes sur ces volumes.
5. Terraform
Peu traité dans les comparatifs, ce sujet pèse pourtant lourd en production. C’est là qu’on a relevé le plus de différences concrètes entre les deux providers Terraform.
Snowflake
La connexion au provider se fait par une paire de clés RSA. Créer bases, warehouses, schémas, rôles et users est direct. Avec une approche « YAML as code », ces objets sont déclarés dans des fichiers de configuration plutôt que codés un par un : le code est facile à maintenir et à factoriser.
Les limites apparaissent dès qu’on touche au Data Lake. La connexion à GCS et les external tables reposent sur des ressources encore en preview :
- l’auto-interprétation du schéma d’un fichier Parquet oblige à injecter du SQL dans Terraform (via
snowflake_execute), ce qu’on cherche justement à éviter en IaC ; - l’alternative (
snowflake_external_table) impose de déclarer manuellement chaque colonne et son type, ce qui n’est pas tenable en production ; - aucune ressource Terraform ne permet de piloter un projet dbt. Snowflake propose bien une fonctionnalité native pour importer et exécuter un projet dbt (dbt Projects on Snowflake), mais elle se gère en dehors de Terraform.
Contournement retenu : considérer le Stage Snowflake comme la couche RAW et travailler directement vers le Staging dbt. Les features Data Lake évoluent vite, à suivre.
Databricks
Databricks demande deux providers (un workspace, un account pour Unity Catalog et les groupes), ce qui alourdit le démarrage. En échange, Unity Catalog centralise la gouvernance : plus besoin de déclarer les grants objet par objet. Sur le Data Lake, l’approche est plus directe :
- connexion GCS native et stable : en laissant le bloc service account vide, Databricks provisionne lui-même un compte de service managé dont on récupère l’e-mail pour les permissions, sans création manuelle ;
- external tables sans douleur :
databricks_sql_tableen typeEXTERNAL+ formatPARQUETsuffit, schéma auto-inféré, sans SQL embarqué ; - dbt nativement orchestré :
databricks_jobembarque unedbt_task(source Git, environnement Python isolé, paramètres passés dynamiquement).
Là où Snowflake passe par du SQL embarqué ou des ressources en preview, Databricks s’appuie sur des ressources stables. Deux réserves toutefois : les policies de masquage ne sont pas gérées par le provider (script SQL ou API REST nécessaire) ; l’oubli du paramètre warehouse_id sur databricks_sql_table fait tourner la planification indéfiniment, sans erreur ni log pour le signaler.
| Terraform / IaC | Snowflake | Databricks |
|---|---|---|
| Création objets (DB, WH, rôles) | ✅ Simple, YAML as code | ✅ OK (2 providers) |
| Gouvernance / grants | Ressources par objet | ✅ Centralisée (Unity Catalog) |
| Connexion GCS | ⚠️ Features preview | ✅ Native et stable |
| External tables (Parquet) | ⚠️ Schéma manuel ou SQL | ✅ Auto-inféré |
| Pilotage dbt | ❌ Aucune ressource | ✅ dbt_task native |
| Masking policies via TF | ✅ Preview (Enterprise) | ⚠️ SQL / API requis |
6. Industrialisation : dbt et orchestration
Côté dbt, rien ne dépayse : un profiles.yml de quelques lignes suffit des deux côtés (type snowflake ou databricks, credentials via variables d’environnement, threads). L’adaptateur dbt-snowflake est très mature, dbt-databricks bien supporté et en progression rapide.
| Critère | dbt-snowflake | dbt-databricks |
|---|---|---|
| Maturité de l’adaptateur | ✅ Très mature | ✅ Bien supporté |
| Stratégies incrémentales | append · merge · insert_overwrite | + replace_where |
| Modèles Python | Snowpark | PySpark |
| Orchestration native du run | dbt Projects (hors Terraform) | databricks_job / dbt_task |
La différence se joue dans l’orchestration du run. Databricks offre un chemin intégré et déclaré en Terraform : un job natif qui exécute dbt. Snowflake permet aussi d’exécuter et de planifier un projet dbt nativement (dbt Projects on Snowflake), mais ce déploiement se gère hors Terraform. Pour le reste, les deux s’appuient sur les mêmes standards : provider Airflow officiel de chaque côté, dbt Cloud, Prefect, Dagster. Aucune raison de trancher là-dessus. Sur GCP, un orchestrateur serverless comme Google Workflows reste par ailleurs une alternative économique à un Airflow toujours actif, un arbitrage à mener indépendamment du choix de la plateforme.
| Orchestrateur | Snowflake | Databricks |
|---|---|---|
| Apache Airflow | ✅ Provider officiel | ✅ Provider officiel |
| dbt Cloud | ✅ | ✅ |
| Prefect / Dagster | ✅ | ✅ |
| Job natif intégré | ✅ dbt Projects on Snowflake | ✅ databricks_job (+ dbt_task) |
7. Les serveurs MCP managés
Sujet émergent mais déjà utile pour les agents data : les deux plateformes exposent un serveur MCP (Model Context Protocol) managé, qui donne à un agent IA un accès SQL et aux fonctions natives sans infrastructure à déployer.
- Maturité : Snowflake est en disponibilité générale, Databricks en public preview. Setup plus simple côté Snowflake (
CREATE MCP SERVERen SQL, RBAC natif). - Authentification : Snowflake accepte OAuth, PAT et clés JWT ; Databricks impose OAuth U2M (friction avec VS Code / Copilot).
- Gouvernance : Databricks reprend l’avantage avec un audit MCP dédié (AI Gateway) : qui appelle quel outil, depuis quel client.
Pour un agent interactif, Snowflake est aujourd’hui plus simple. Pour une gouvernance MCP centralisée à l’échelle d’une organisation lakehouse, Databricks offre l’audit que Snowflake n’a pas encore.
8. Quelle plateforme pour quel workload ?
Pas de gagnant universel : le bon choix dépend du profil de charge. À parité économique, il se joue aussi sur des critères que le benchmark ne mesure pas : le stack existant, les compétences de l’équipe, les intégrations. L’UX, elle, se vaut des deux côtés.
| Profil de workload | Reco | Pourquoi |
|---|---|---|
| Workloads quotidiens, perf modérée | Indifférent | Parité économique à perf équivalente (x1,04). Le choix se joue sur le stack existant, les compétences et les intégrations. |
| SLA tendu, batch performance-critique | Databricks Large | Sweet spot de performance : 146 s / run, $1,77. 2x plus rapide que Snowflake X-Large, pour -49 % de coût. |
| Forte concurrence (≥ 8 exécutions //) | Snowflake Large | +25 % de rapidité, -24 % de coût vs Databricks Medium à budget équivalent, avec une variance 2x plus basse sous charge. |
Un dernier réflexe d’architecte : si les mêmes données doivent servir du ML, du SQL analytique et des transformations dbt, l’unification autour de Delta Lake plaide pour Databricks, au-delà de ce benchmark. À l’inverse, une équipe SQL-first qui vise l’onboarding le plus court et une gouvernance IaC clé en main sera plus vite opérationnelle sur Snowflake.
L’essentiel
| Votre priorité | Plateforme | Pourquoi |
|---|---|---|
| Prise en main rapide, équipe SQL-first | Snowflake | Démarrage simple : un seul provider Terraform, création d’objets directe, adaptateur dbt très mature. |
| Gouvernance centralisée | Databricks | Unity Catalog centralise les grants ; audit des appels MCP via AI Gateway. |
| Petits volumes (~1 Go) | Snowflake | ~40 % de durée en moins, sans cold-start. |
| Gros volumes, SLA tendu | Databricks | Databricks Large : 146 s / run à SF100, 2x plus rapide que Snowflake X-Large pour -49 % de coût. |
| Forte concurrence (≥ 8 exécutions //) | Snowflake | Snowflake Large : +25 % de rapidité, -24 % de coût, variance 2x plus basse. |
| Data Lake et industrialisation en IaC | Databricks | Connexion GCS native, external tables auto-inférées, dbt orchestré depuis Terraform. |
| Agent IA via MCP | Snowflake | Serveur MCP en disponibilité générale, setup en SQL. |
| Budget équivalent, workloads courants | Indifférent | Écart de coût de x1,04 : le stack existant et les compétences de l’équipe font la différence. |
Snowflake ou Databricks n’a pas de réponse absolue : le choix se pilote par vos contraintes, pas par un classement. À budget équivalent, les deux se valent économiquement. Databricks prend l’avantage sur la performance maximale et le Data Lake, Snowflake sur la stabilité sous charge et la simplicité d’industrialisation SQL. La question n’est pas de savoir laquelle est la meilleure, mais laquelle colle à mon workload et à mon équipe.