Un Company Brain est une mémoire partagée qui rassemble la connaissance d'une entreprise (documents, décisions, données métier, code) et la met à disposition de ses agents IA de façon durable et sécurisée. Il fonctionne avec un Agent Harness, la couche logicielle qui encadre le modèle de langage : droits d'accès, choix des outils, budget d'étapes et validation humaine des actions sensibles. Ensemble, ils évitent aux équipes de réexpliquer leur contexte à chaque session et permettent de passer d'assistants isolés à des agents fiables en production.
Ce guide présente d'abord le rôle du Company Brain, puis le fonctionnement de l'Agent Harness. Il détaille ensuite des cas d'usage, dont un projet mené pour un client du retail, puis compare le Company Brain aux assistants IA clés en main. Il décrit enfin les briques d'architecture, les solutions open source disponibles et la démarche que nous recommandons chez Modeo.
Qu'est-ce qu'un Company Brain ?
Un Company Brain est une base de connaissance unifiée, alimentée en continu, que tous les agents IA d'une entreprise consultent pour travailler avec le même contexte. Il relie les informations selon les entités métier réelles (produits, clients, projets, fonctions de code) au lieu de stocker des fichiers isolés.
Pourquoi les assistants IA oublient tout d'une session à l'autre
Sans mémoire partagée, un assistant IA réinitialise son contexte à chaque nouvelle session. Les informations utiles restent dispersées dans le CRM, les repositories de code, les bases SQL et les tickets d'incident. Les collaborateurs copient-collent donc les mêmes consignes et les mêmes documents d'un outil à l'autre.
Cette réinjection manuelle ralentit le travail et alourdit les prompts envoyés aux modèles. Or un prompt plus long coûte plus cher en appels API et allonge le temps de réponse. Une couche de mémoire persistante supprime cette répétition et conserve l'historique des décisions de l'entreprise. Elle demande en revanche des routines d'archivage pour ne pas conserver d'informations obsolètes.
Une mémoire organisée autour des entités métier
Un Company Brain remplace la recherche textuelle sur des fichiers isolés par une représentation des liens entre les entités de l'entreprise. Le framework open source Cognee illustre cette approche : il relie les produits, les retours clients et les fonctions de code dans un knowledge graph (graphe de connaissances). Plusieurs agents travaillant pour des services différents consultent ensuite la même source.
Cette centralisation apporte trois bénéfices concrets :
- une terminologie commune entre les équipes produit et ingénierie ;
- moins de réunions de synchronisation entre services ;
- un accès permanent à l'historique des choix d'architecture pour les nouveaux arrivants.
Un knowledge graph doit toutefois être mis à jour automatiquement pour suivre l'évolution quotidienne du code et des documents.
Mémoire réactive et mémoire proactive
La mémoire réactive retient uniquement les faits transmis pendant une conversation. C'est le fonctionnement des assistants classiques. La mémoire proactive, au contraire, va chercher elle-même les nouveautés dans les applications de l'entreprise, sans attendre de consigne.
OpenWiki Brains, publié par LangChain en juillet 2026, applique ce principe. Ses connecteurs interrogent Gmail, Notion, les repositories Git, X, Hacker News ou la recherche web. Une tâche planifiée met ensuite à jour un wiki de fichiers Markdown stocké en local. Les collaborateurs disposent ainsi d'un contexte à jour dès le début de leur journée. Les quotas d'appels API imposés par les éditeurs limitent cependant la fréquence de ces extractions.
Des droits d'accès gérés au même endroit
Le Company Brain centralise le contrôle d'accès pour protéger les informations confidentielles sans alourdir le code des agents. Écrire les règles de confidentialité dans chaque prompt crée des failles et complique la gestion des droits. Le Company Brain attribue plutôt un scope (périmètre d'accès) à chaque conteneur de mémoire.
Le Company Brain open source de Supermemory utilise par exemple le tag sm_org_shared pour la mémoire des canaux publics et slack_channel_{id} pour les canaux privés. Avant chaque recherche, le runtime vérifie l'identité de l'utilisateur et ne consulte que les conteneurs autorisés. Un employé qui lance une recherche technique ne tombe donc jamais sur un compte rendu confidentiel des ressources humaines. Le raccordement à un annuaire d'entreprise complexe demande néanmoins une configuration de sécurité spécifique.
Comment fonctionne un Agent Harness ?
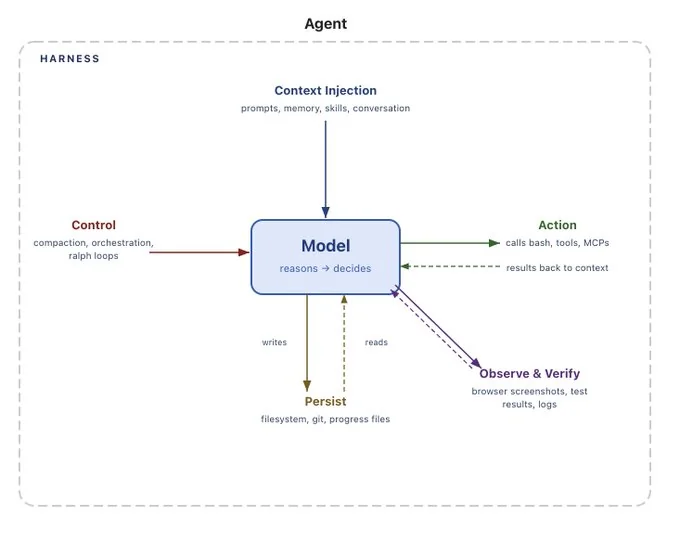
Un Agent Harness est la couche logicielle qui entoure le modèle de langage pour contrôler ce qu'il voit, ce qu'il peut faire et quand il doit s'arrêter. Un modèle seul ne sait ni vérifier les droits d'un utilisateur ni appliquer les règles de sécurité d'une entreprise : le harness s'en charge à sa place.
Le runtime : état, outils et règles de sécurité
Le runtime (environnement d'exécution) conserve l'état de chaque session et décide des outils auxquels le modèle a accès. Dans le Company Brain de Supermemory, ce rôle revient au composant CompanyBrainAgent, un Durable Object Cloudflare créé pour chaque organisation et déployé sur Cloudflare Workers. Il enregistre l'état dans une base SQL locale, route les messages vers le modèle et valide les règles de confidentialité avant chaque appel externe. Il permet aussi de reprendre une tâche interrompue par une panne de serveur.
Supermemory a arrêté son offre commerciale Company Brain en septembre 2026, puis a publié le code et l'architecture de son harness en open source. Le projet reste une référence d'architecture, mais il n'est plus maintenu comme un produit.
Le triage : répondre, enquêter, réagir ou se taire
Le triage évalue chaque message reçu pour décider si l'agent doit intervenir. Un modèle de classification léger note l'événement de 0 à 100 selon plusieurs critères, dont l'utilité, l'urgence et le coût d'une interruption. Un évaluateur déterministe choisit ensuite l'une des quatre actions suivantes :
- ANSWER lance un cycle de raisonnement complet pour répondre ;
- INVESTIGATE rassemble des informations sans publier de message ;
- ACK se contente d'une réaction emoji sur Slack ;
- PASS garde le silence quand la discussion ne demande aucune aide.
Cette participation sélective préserve la tranquillité des canaux de l'équipe. Un prompt de triage mal calibré risque cependant d'ignorer une demande légitime.
Gérer les messages qui arrivent pendant une tâche
Dans un chat d'équipe, les collaborateurs continuent d'écrire pendant que l'agent travaille. Un intercepteur évalue alors chaque nouveau message du fil en cours et choisit entre quatre décisions :
- IGNORE quand le message s'adresse à un collègue ;
- APPEND pour ajouter l'information au raisonnement en cours ;
- REPLACE pour abandonner la tâche et répondre à la nouvelle demande ;
- STOP pour arrêter l'opération à la demande de l'utilisateur.
Ce contrôle évite de consommer des tokens sur une demande devenue obsolète. Annuler une tâche peut toutefois laisser des opérations à moitié faites dans un outil tiers qui ne gère pas le retour arrière (rollback).
Le step budget : limiter les boucles d'appels
Le step budget fixe le nombre maximal d'appels d'outils autorisés pour une même demande, par exemple 10. Trois étapes avant la limite, le harness prévient le modèle. À la dernière étape, il retire la liste des outils du prompt. Le modèle doit alors rédiger une réponse avec les informations déjà collectées.
Ce mécanisme empêche un agent de chercher indéfiniment sans jamais répondre. En contrepartie, la synthèse forcée peut rester partielle si un document clé n'a pas encore été trouvé.
Cas d'usage d'un Company Brain en entreprise
Un Company Brain sert d'abord à répondre aux questions métier qui demandent de croiser plusieurs outils, à aligner les équipes et à assister les collaborateurs là où ils travaillent déjà.
Retour d'expérience : interroger ses données en langage naturel dans le retail
Chez l'un de nos clients, un retailer, les données de l'ERP, de la finance, de la production et du service client sont centralisées dans un data warehouse Snowflake. Les équipes métier n'avaient pourtant aucune interface pour interroger ces sources de manière croisée : les assistants intégrés à chaque logiciel, comme celui de Zendesk, restent limités à leur propre périmètre.
Une interface conversationnelle connectée au Company Brain répond désormais à des questions comme :
- Quels composants arriveront au cours de la semaine ?
- Quels produits risquent une rupture de stock et à quelle échéance ?
- Quel chiffre d'affaires génère une catégorie de produits donnée ?
L'agent s'appuie sur l'image quotidienne des données centralisées dans Snowflake, sans traitement en temps réel. Les équipes n'ont plus à écrire de requêtes complexes. Ce premier périmètre a aussi servi à cadrer le premier cas d'usage métier avant d'étendre l'agent à d'autres sources.
Aligner produit et ingénierie
Le Company Brain répercute les décisions produit jusque dans le code. Lorsqu'un responsable produit renomme une fonctionnalité sur le site, un agent enregistre la décision. Le knowledge graph la relie à la documentation, aux retours clients et aux fonctions de code concernées.
Un agent qui travaille dans un autre repository détecte alors le changement de terminologie. Plutôt que de modifier le code public, il ouvre une pull request qui ajoute un alias et met à jour la documentation. Un développeur relit et valide cette proposition avant la fusion.
Un assistant dans les canaux de discussion
Intégré à Slack, l'agent écoute les canaux publics, note les décisions importantes et répond quand un collaborateur le sollicite. Les questions techniques n'atterrissent plus systématiquement en message privé chez les ingénieurs seniors. Les nouveaux arrivants prennent aussi leurs outils en main plus vite.
Dans une étude de cas publiée en juin 2026, Supermemory indique que le temps de réponse moyen de l'assistant de Chatarmin est passé de 40 à 12 secondes après le passage à une architecture fondée sur la mémoire. Les collaborateurs doivent cependant apprendre à vérifier les documents sources joints aux réponses.
Exemple : l'assistant interne de Modeo
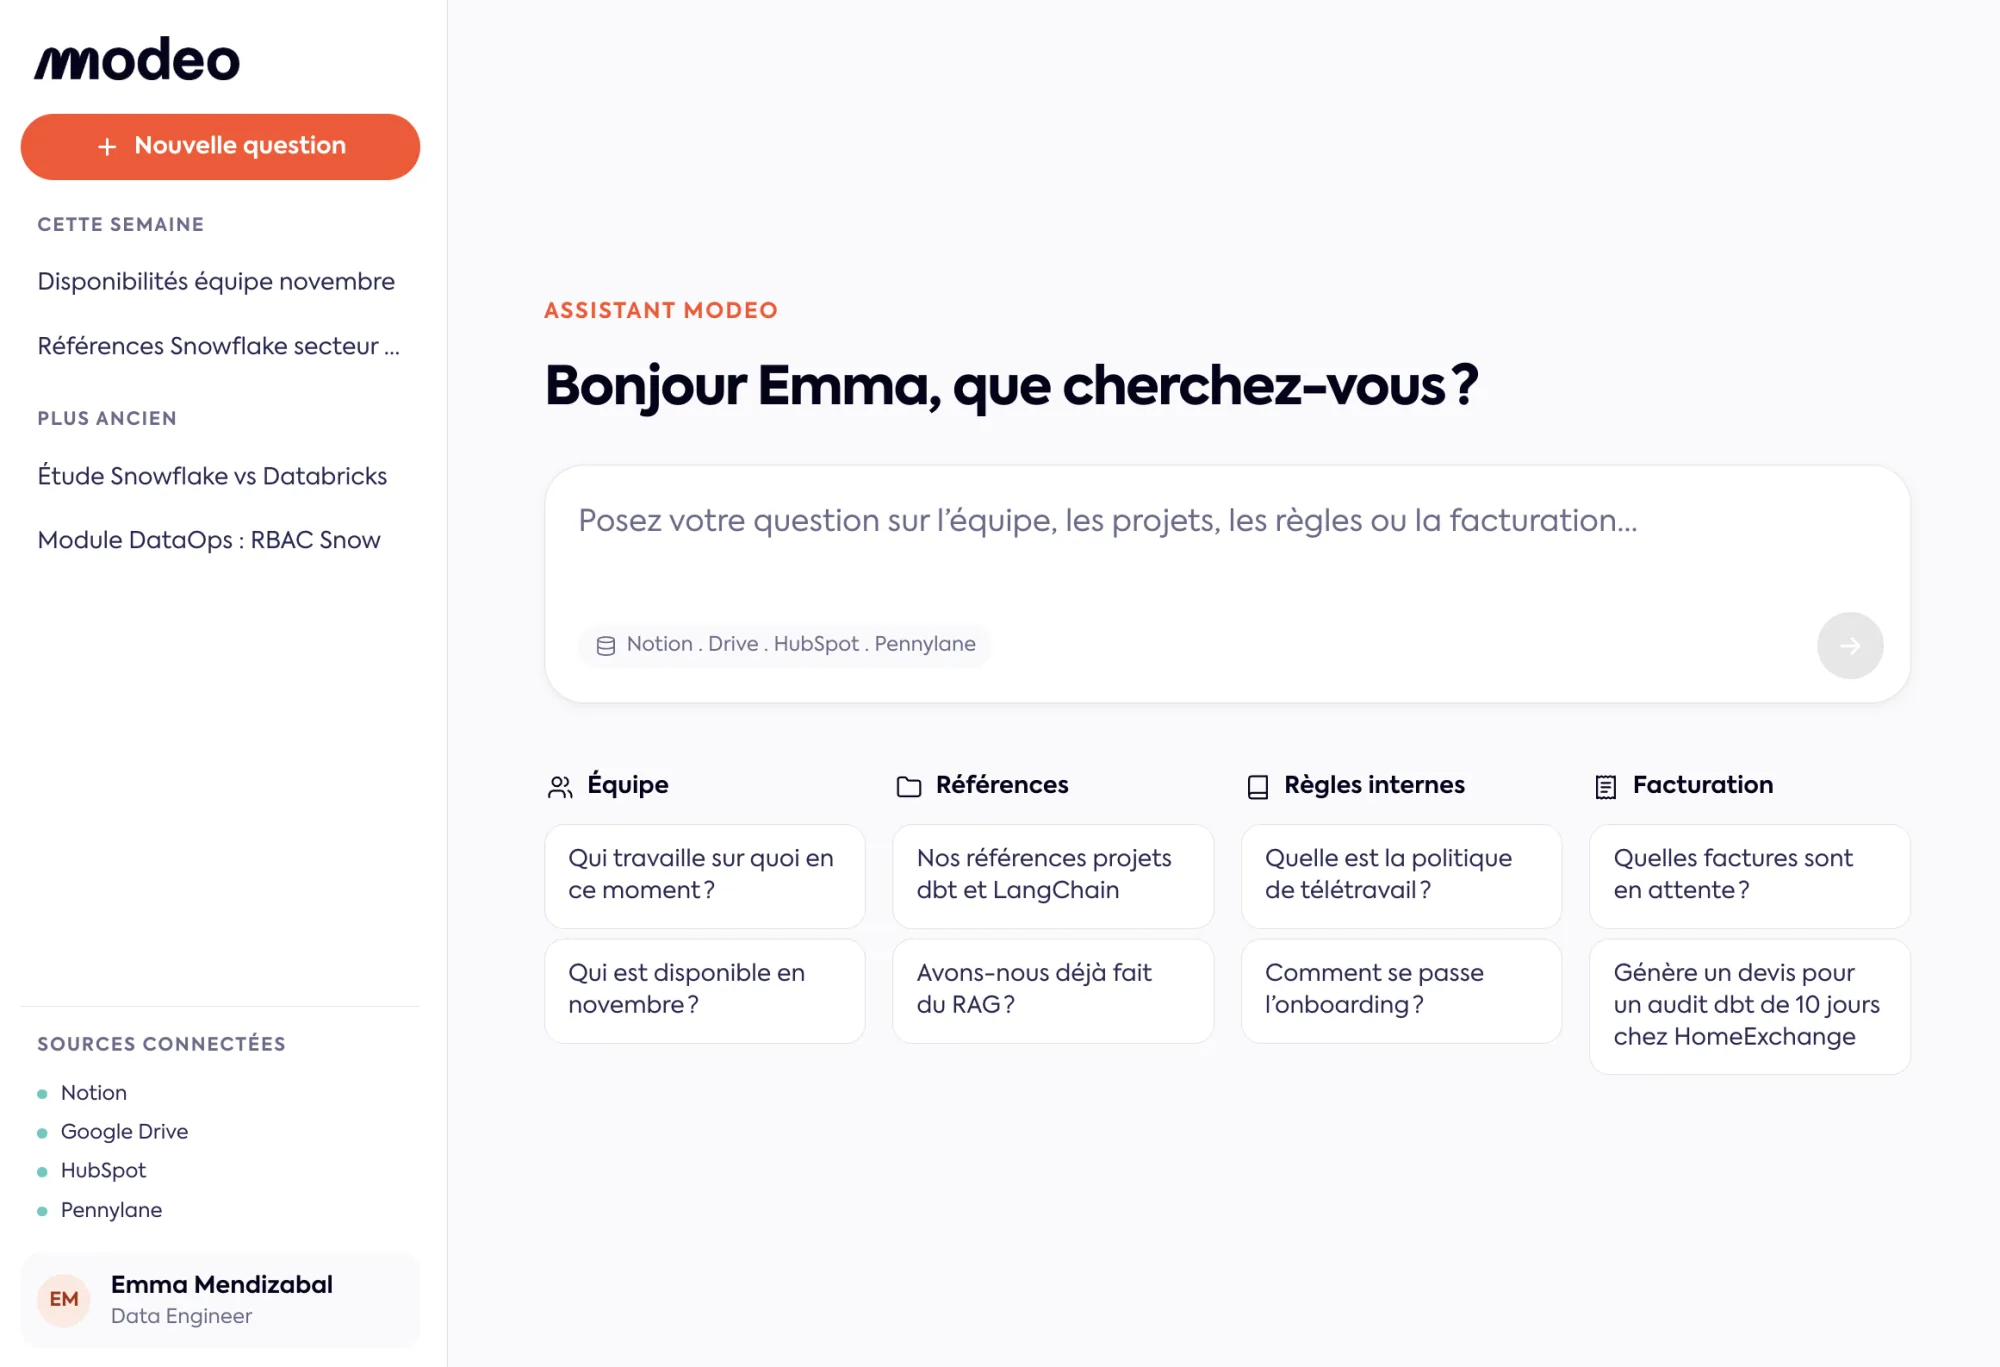
Chez Modeo, notre assistant interne est connecté à Notion, Google Drive, HubSpot et Pennylane. Il répond aux questions sur l'équipe (qui travaille sur quoi, qui est disponible), nos références projets, nos règles internes et la facturation.
Company Brain ou assistant IA clé en main : que choisir ?
Un assistant clé en main comme ChatGPT Team ou Claude Enterprise suffit pour démarrer. Un Company Brain devient préférable dès que l'entreprise a besoin de connecteurs spécifiques, de droits d'accès fins, d'une mémoire partagée entre plusieurs agents et d'un suivi précis en production.
| Critère | Assistant IA clé en main | Company Brain |
|---|---|---|
| Mise en route | Immédiate | Projet d'ingénierie de plusieurs semaines |
| Coût | Abonnement par utilisateur | Infrastructure et appels API, optimisés par le harness |
| Connecteurs | Catalogue de l'éditeur | Connecteurs développés selon vos besoins |
| Mémoire | Limitée à un utilisateur ou un projet | Partagée entre agents, équipes et services |
| Droits d'accès | Réglages de l'éditeur | RBAC au niveau de chaque conteneur de mémoire |
| Observabilité | Limitée | Traçage complet de chaque décision |
Des coûts maîtrisés par le harness
Le coût d'un assistant clé en main suit le nombre d'utilisateurs. Celui d'un Company Brain dépend surtout du volume d'appels au modèle, que l'Agent Harness réduit de trois façons :
- le triage écarte les messages qui ne demandent pas de réponse ;
- le step budget plafonne le nombre d'appels d'outils par demande ;
- la mémoire évite de réinjecter tout le contexte dans chaque prompt.
Des connecteurs et une mémoire adaptés à l'entreprise
Les plateformes fermées proposent des configurations standardisées. Ajouter un connecteur maison ou une règle métier complexe y devient vite impossible. Avec un Company Brain, l'entreprise garde le code source et fait évoluer ses connecteurs. Les décisions prises par une équipe restent accessibles aux agents des autres services, mois après mois.
Un suivi en production
Un Company Brain s'intègre aux outils d'observabilité comme LangSmith pour tracer chaque décision de l'agent. L'entreprise repère ainsi les questions récurrentes, identifie les informations manquantes dans sa base de connaissance et transforme les retours des utilisateurs en jeux de données d'évaluation.
Des droits d'accès fins
Un assistant connecté à un dossier partagé risque d'exposer des documents confidentiels à des employés non autorisés. Le Company Brain applique un contrôle d'accès basé sur les rôles (RBAC) au niveau du stockage : chaque agent n'accède qu'au périmètre nécessaire à sa mission. Cette configuration suppose un inventaire rigoureux des permissions, un chantier proche de celui de la gouvernance des données.
Les briques d'architecture d'un Company Brain
Un Company Brain repose sur quatre briques : une mémoire séparée de l'état opérationnel, des conteneurs d'accès, un registre des questions ouvertes et un circuit de validation humaine.
Mémoire sémantique et état opérationnel
La mémoire sémantique conserve ce qui dure : choix stratégiques, documentation produit, organigramme. L'état opérationnel regroupe ce qui change vite, comme le statut d'un ticket ou le dernier déploiement. Le Company Brain de Supermemory associe la recherche vectorielle pour la première et des appels API directs pour la seconde.
Un agent consulte ainsi la mémoire pour comprendre les objectifs d'un projet, puis interroge GitHub en direct pour vérifier l'état du code. La base de connaissance reste légère et les statuts restent exacts. En contrepartie, une panne d'API externe bloque temporairement la vérification en direct.
Des conteneurs de mémoire par scope
Chaque information reçoit un tag d'accès au moment de son intégration :
sm_org_sharedla rend accessible à toute l'entreprise ;slack_channel_{id}la réserve aux membres d'un canal privé ;user_{userId}la limite à un seul utilisateur.
Le runtime filtre la recherche selon l'identité de la personne qui interroge l'agent. Un rapport financier confidentiel n'apparaît donc pas dans la recherche générale d'un employé. Un tag erroné à l'intégration peut en revanche masquer un document à des collaborateurs qui y ont droit.
Un registre des questions ouvertes
Un registre des questions ouvertes empêche l'agent d'inventer une réponse quand une information manque. Lorsque l'ingestion rencontre un sigle inconnu ou un terme ambigu, elle ajoute une entrée dans un fichier dédié, par exemple open_questions.md. Aux passages suivants, l'agent cherche la réponse dans les nouveaux documents. Les équipes peuvent aussi compléter le fichier directement. Ce registre doit être suivi, faute de quoi les questions non résolues s'accumulent.
La validation humaine des actions sensibles
Le human-in-the-loop soumet les actions à fort impact, comme l'envoi d'un email, à l'accord d'un humain. Le harness met l'exécution en pause, sauvegarde l'état du raisonnement et affiche une carte Approve / Deny dans Slack. Après validation, l'agent reprend exactement là où il s'était arrêté. LangSmith permet aussi de construire des interfaces de relecture sur mesure pour inspecter ces actions. Le délai d'attente ralentit les traitements, mais garantit leur conformité avec la politique de risques de l'entreprise.
Ces briques reposent sur une data platform solide. Comme nous l'expliquions au salon Big Data & AI 2026 en revenant sur le projet mené avec RATP Cap Île-de-France, la plateforme doit encapsuler des process clairs : automatisation, DataOps, gouvernance, observabilité et CI/CD. Sans ces fondations, un agent ne sait ni déployer un job dbt, ni créer un test sur une nouvelle intégration de données, ni octroyer des droits.
Quelles solutions open source pour construire un Company Brain ?
Aucune solution ne couvre seule tout le périmètre : un Company Brain s'assemble à partir de briques open source spécialisées, chacune avec ses limites.
| Solution | Rôle | Limite principale |
|---|---|---|
| OpenWiki Brains (LangChain) | Mémoire proactive sous forme de wiki Markdown, alimentée par des connecteurs | Installation locale : la machine hôte doit rester allumée |
| Cognee | Structuration de la connaissance en knowledge graph | Construction initiale coûteuse en tokens |
| Supermemory Company Brain | Harness multi-utilisateurs pour Slack sur Cloudflare Workers | Produit arrêté, code publié en open source |
| LangGraph | Orchestration d'agents avec gestion des états | Harness à construire soi-même |
| LangSmith | Observabilité et évaluation des agents | Service cloud de LangChain |
OpenWiki Brains
OpenWiki Brains génère une mémoire générale sous forme de fichiers Markdown lisibles. L'outil s'installe via npm et s'initialise avec la commande openwiki personal --init. Une tâche planifiée rafraîchit ensuite le wiki. Le code est disponible sur le repository OpenWiki de LangChain.
Cognee
Cognee extrait des documents les entités clés (produits, fonctions de code, retours clients) et navigue dans les liens qui les relient, au-delà de la simple proximité de mots. Plusieurs agents travaillant dans des repositories différents partagent ainsi le même contexte métier. La construction initiale du graphe consomme cependant beaucoup de tokens.
Supermemory et Cloudflare
Le Company Brain de Supermemory s'appuie sur Cloudflare Workers et des Durable Objects, qui conservent l'état des sessions et assurent la reprise après une panne. Le code publié reste une base utile pour concevoir son propre harness. Un déploiement serverless impose toutefois de respecter les limites de durée d'exécution de Cloudflare Workers.
Une ingestion source par source
Nous recommandons d'ingérer les sources l'une après l'autre plutôt que simultanément. Analyser en même temps des emails, des pages Notion et des commits risque de saturer la fenêtre de contexte du modèle. Le pipeline traite donc un connecteur, met à jour la mémoire, réinitialise la session puis passe au connecteur suivant. L'extraction gagne en précision, au prix d'une mise à jour complète plus longue.
Comment déployer un Company Brain : la démarche Modeo
Un Company Brain se déploie par étapes, en partant d'un périmètre restreint avant d'ouvrir l'agent à toute l'entreprise. Nous suivons quatre étapes :
- Auditer les sources de données et choisir les applications prioritaires : Notion, GitHub, Snowflake ou le CRM.
- Déployer le runtime avec Cloudflare Agents SDK ou LangGraph pour gérer le triage et le step budget.
- Configurer l'ingestion en arrière-plan avec un registre des questions ouvertes pour contrôler la qualité.
- Ajouter la validation humaine sur les outils qui modifient des données externes, avant toute automatisation complète.
Commencer par un périmètre ciblé, comme les données Snowflake de notre client retail, permet de valider le fonctionnement avant d'étendre l'agent aux canaux de communication.
Notre équipe d'AI engineering conçoit ces architectures avec LangChain, LangGraph, OpenWiki Brains et Cloudflare Agents SDK : audit de sécurité des données, développement du runtime, isolation des scopes d'accès et pipelines d'évaluation sur LangSmith. Pour évaluer la préparation de vos données et définir votre premier cas d'usage, réservez un échange de 30 minutes avec un ingénieur Modeo. Il débouche, si besoin, sur un atelier de cadrage technique de deux heures.
Questions fréquentes sur le Company Brain
Quelle différence entre un Company Brain et un RAG ?
Un RAG (Retrieval-Augmented Generation) retrouve des extraits de documents proches d'une question et les fournit au modèle. Un Company Brain l'utilise souvent comme composant, mais y ajoute une mémoire persistante partagée entre agents, des liens entre entités métier, une ingestion proactive et des droits d'accès. Notre article sur la mise en place d'un agent conversationnel RAG sur AWS détaille la première approche.
Faut-il une data platform pour construire un Company Brain ?
Pas pour démarrer sur des documents comme Notion ou Google Drive. Pour répondre à des questions chiffrées (stocks, chiffre d'affaires, délais), l'agent a besoin de données fiables et centralisées, par exemple dans Snowflake ou BigQuery. C'est pourquoi notre projet dans le retail s'appuie sur un data warehouse existant.
Quelles sources connecter en premier ?
Les sources sur lesquelles les équipes perdent le plus de temps à chercher l'information : documentation interne, CRM, data warehouse et outil de ticketing. Mieux vaut connecter deux ou trois sources bien gouvernées que dix sources sans règles d'accès.
Comment éviter qu'un agent invente des réponses ?
En combinant plusieurs garde-fous : citer les documents sources dans chaque réponse, tenir un registre des questions ouvertes, limiter le step budget et soumettre les actions sensibles à une validation humaine. Le suivi dans un outil d'observabilité comme LangSmith permet ensuite de repérer et de corriger les mauvaises réponses.
Glossaire
- Agent Harness : couche logicielle qui entoure le modèle de langage pour gérer la sécurité, les outils, l'état des sessions et les règles d'accès.
- Company Brain : mémoire partagée et centralisée qui fournit un contexte persistant aux agents IA d'une organisation.
- Durable Objects : composants serverless de Cloudflare qui conservent l'état d'une session de manière persistante.
- Human-in-the-loop : mécanisme qui suspend un agent pour soumettre une action critique à l'approbation d'un humain.
- Knowledge graph : organisation des données qui relie les concepts métier entre eux sous forme de réseau.
- RBAC (Role-Based Access Control) : contrôle d'accès qui restreint les données selon le rôle de chaque utilisateur.
- Scope : périmètre de visibilité d'une donnée (toute l'organisation, un canal, un utilisateur).
- Step budget : nombre maximal d'appels d'outils autorisés pour une demande.
- Triage : évaluation automatique d'un message pour décider si l'agent répond, enquête, réagit ou se tait.